
KI erkennt Bilder schlechter als Menschen: Selbst moderne KI-Modelle scheitern (noch) an der Form
Menschen erkennen Gegenstände oft an ihrer Gesamtform. Künstliche neuronale Netze hingegen verlassen sich auf andere Anzeichen – wie die Oberflächentextur – und werden selbst bei ausgefeiltestem Training vom menschlichen Sehen übertroffen.
Eine Bild-KI kann auf einer gewöhnlichen Fotografie einen Bären zuverlässig erkennen. Verändert man jedoch die Darstellung, offenbart sich eine grundlegende Schwäche der Technik: Wo Menschen die Gesamtform weiterhin nutzen, verlieren viele KIs ihre Orientierung. Und das gilt sogar für Systeme, die bisher für eher menschenähnlich gehalten wurden.
Forschende der NYU Grossman School of Medicine haben nun eine neue Studie dazu im Fachjournal iScience veröffentlicht, in welcher sie die Erkennungsleistung von 70 Erwachsenen mit über 200 tiefen neuronalen Netzen verglichen haben. Die KI-Modelle unterschieden sich dabei in puncto Architektur (also IT-Konzeption), Trainingsdaten und Lernzielen.
Visuelle Grundlage verändert
Als Bildmaterial nutzten die Wissenschaftler 240 Alltagsfotografien aus 48 Objektklassen. Die Bilder wurden so verändert, dass Textur, innere Bestandteile und globale Form einzeln oder kombiniert erkennbar waren.
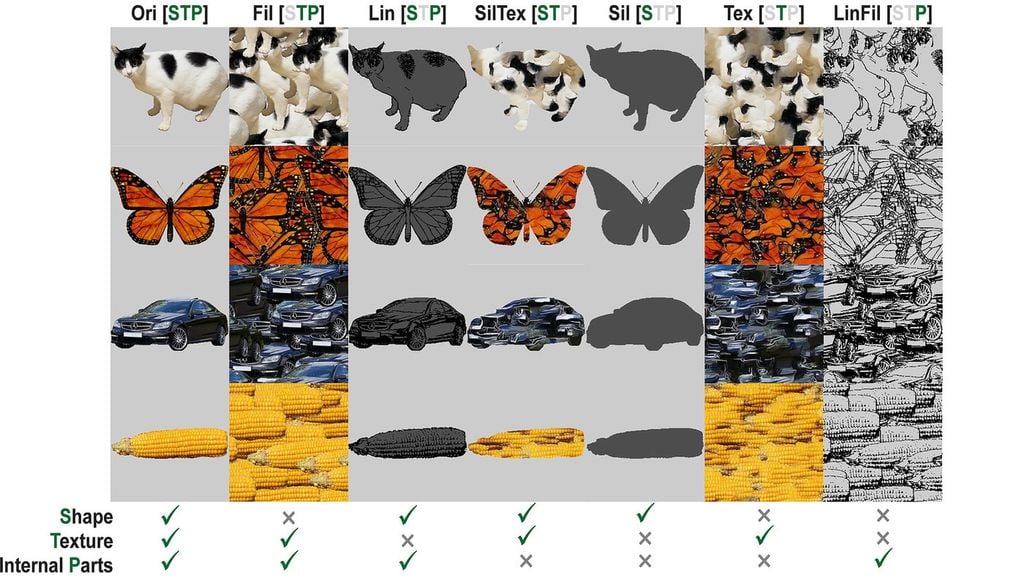
Menschen erkannten solche Darstellungen weiterhin gut. Die KI-Modelle hingegen lagen eher daneben. Eine Standard-KI klassifizierte 95 Prozent der spärlich gesetzten Pluszeichenbilder als „Kreuzworträtsel“. Andere Systeme tippten auf „Fliegengitter“ oder „Kettenhemd“. Kein Modell erreichte das menschliche Niveau, wenn die globale Form entscheidend war.
Klassische Modelle setzten zudem häufig stärker auf Texturen als auf Formen. Training mit unscharfen oder stilisierten Bildern änderte daran wenig. Solche Verfahren erzeugten in älteren Tests einen stärkeren Form-Bias, weil sie Texturen schlechter auswerteten.
Bild mit Sprache
Am ehesten näherten sich Modelle dem menschlichen Verhalten an, die gemeinsam mit Bildern und schriftlichen Bildbeschreibungen trainiert worden waren. Damit war die Trainingsart wichtiger als das eigentliche KI-Modell. Nach zusätzlichem Training mit der Bilddatenbank ImageNet konnten sich einige Systeme jedoch bei reinen Umrissbildern mehr dem Menschen annähern.
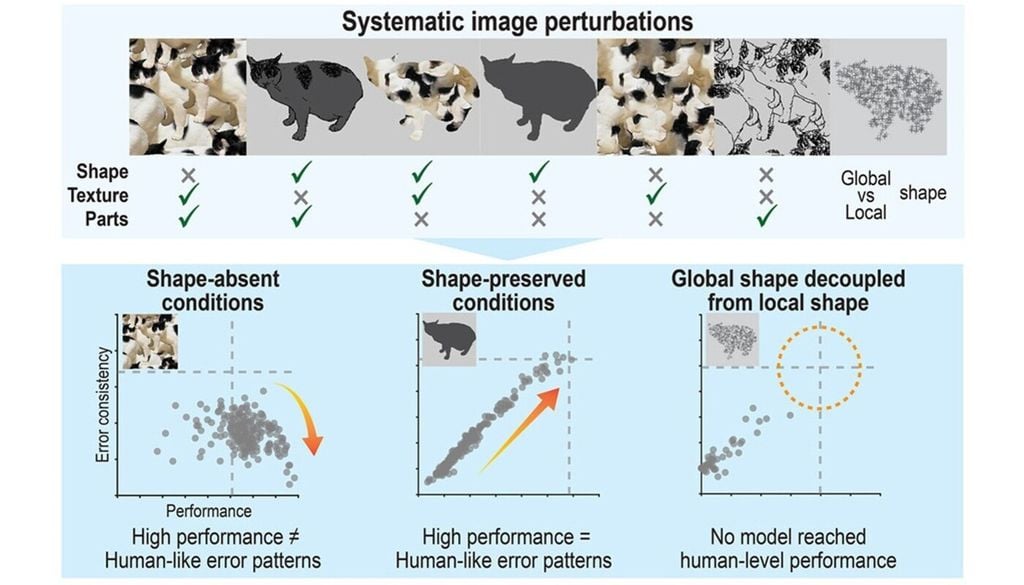
Doch auch hier blieb die Übereinstimmung lückenhaft. Ein Modell kann eine höhere Trefferquote als Menschen erzielen und trotzdem veränderte Bilder als schwierig einstufen. „Aktuelle KI-Modelle erreichen nicht die gleiche Wahrnehmung visueller Objekte wie Menschen“, sagt die renommierte Neurowissenschaftlerin Dr. Biyu He, die als Associate Professor an der NYU Grossman School of Medicine tätig ist.
Leistung und Menschenähnlichkeit sind nämlich nicht dasselbe. Ein Vergleich mit neuronalen Messdaten ergab, dass selbst Modelle mit guter Übereinstimmung zu menschlichen Hirndaten beim Formtest deutliche Schwächen zeigten.
Hinzu kommt, dass Testpersonen die ungewohnten Pluszeichenbilder ohne vorheriges Training bewältigten. Auch die Vorteile sprachgestützter Modelle lassen sich noch nicht eindeutig erklären. Sie wurden mit Hunderten Millionen bis Milliarden Bildern trainiert – also wesentlich mehr als die rund 1,2 Millionen Bilder von ImageNet. Unklar bleibt, ob Sprache, Datenmenge oder größere Vielfalt den Unterschied ausmacht.
Die Studie warnt damit, dass hohe Genauigkeit auf Standardtests nicht zwangsläufig dem menschlichen Sehen ähneln. Künftige Modelle könnten stärker mit alltagsnahen Kategorien trainiert und mit menschlichen Antworten abgeglichen werden. Ob sie dadurch Gegenstände so selbstverständlich über ihre Gesamtform erkennen wie Menschen, muss sich erst zeigen.
Artikelreferenz
Kato, M., & He, B. (2026). Systematic image perturbations reveal persistent gaps between human and machine vision. iScience.